Как работает переводчик
Подробное объяснение простым языком — от подготовки текста до математики перевода
Это разбор того, что происходит внутри системы перевода русский → чувашский: из чего она состоит, почему выбрана именно такая конструкция и что означают термины, которые встречаются в описании. Все числа здесь — из фактических измерений этой модели, а не из литературы.
1Общая картина за три шага
Нейросеть не умеет работать с буквами. Она умеет только умножать числа. Поэтому любой перевод — это три этапа:
Первый и третий шаг — механические, они задаются словарём и обратимы. Вся содержательная работа происходит на втором шаге, и именно он «выучен» из данных: 16 миллионов чисел были подобраны так, чтобы правильные переводы получались чаще неправильных.
Что значит «модель выучила язык». Внутри нет ни словаря соответствий, ни правил грамматики. Есть только 16 миллионов чисел и фиксированная последовательность операций умножения и сложения. Знание языка «размазано» по этим числам: ни в одном отдельном нельзя указать пальцем на «правило образования прошедшего времени».
2Агглютинативный язык — что это
Термин встречается в описании постоянно, потому что от него зависят почти все решения в системе. Разберём на примере.
Русский язык — флективный. Слово меняется целиком, окончание
сплавлено с основой и часто выражает сразу несколько значений:
в слове «книгами» окончание -ами одновременно означает
множественное число и творительный падеж. Разделить эти два смысла
на два куска нельзя — они слиты в одном окончании.
Чувашский язык — агглютинативный (от лат. agglutinare — приклеивать). Значения не сплавляются, а приклеиваются к основе по одному, цепочкой, и каждый аффикс отвечает ровно за одно:
Верхняя часть схемы — принцип, а не конкретная словоформа: реальная чувашская морфология богаче, аффиксы подчиняются законам гармонии гласных, и их сочетаемость требует знания языка. Нижняя часть — настоящий вывод токенизатора этой модели, который можно проверить.
Почему это ломает наивный подход
Если считать единицей текста слово, то каждая комбинация аффиксов — это отдельное слово в словаре. Комбинаций много, поэтому словарь взрывается. На нашем корпусе мы это измерили:
| Уровень | Размер словаря | Из них встречаются 1–2 раза |
|---|---|---|
| слова, чувашский | > 300 000 | более 60 % |
| подсловные единицы | 12 000 | — |
Слово, встретившееся в корпусе один раз, модель выучить не может: одного примера мало. А слово, не вошедшее в словарь вообще, превращается в заглушку «неизвестно», то есть в заведомо неверный перевод. Решение — в разделе 4.
3Подготовка данных
Модель училась на параллельном корпусе — наборе пар «русское предложение / его чувашский перевод», сделанных людьми. Источник — открытый Chuvash-Russian Parallel Corpus, в основном художественная литература.
| Этап | Пар предложений | Что произошло |
|---|---|---|
| Исходный корпус | 1 002 013 | как есть с Kaggle |
| Фильтры | −10 137 | битые и подозрительные пары |
| Дубликаты | −1 232 | повторы |
| Обучение | 984 627 | на этом модель училась |
| Валидация | 3 000 | проверка в ходе обучения |
| Тест | 3 000 | итоговая оценка, модель их не видела |
Что чистим и что трогать нельзя
Убираем: невидимые служебные символы, разнобой в кавычках и
тире, склейки строк без пробела (в корпусе попадались куски вида
…чи не сонГоловоньку… — это дефект выгрузки, распознаётся по
стыку строчной и прописной буквы).
Отбрасываем пару целиком, если: одна сторона пустая; стороны посимвольно совпадают; длиннее 60 слов; одна сторона более чем в 2,5 раза длиннее другой (почти всегда это сбитое выравнивание — напротив русского предложения стоит чужой чувашский); букв кириллицы меньше половины.
А вот чего делать нельзя. В типовых руководствах по обработке текста советуют привести всё к нижнему регистру и удалить пунктуацию. Для классификации это разумно — там важен смысл, а не оформление. Для перевода это катастрофа: регистр и запятые — часть того, что мы хотим получить на выходе. Обучив модель на тексте без заглавных букв, невозможно получить от неё правильно оформленное предложение — эта информация уничтожена ещё до начала обучения. Поэтому здесь текст сохраняется как есть.
Как делится выборка — и почему это важнее, чем кажется
Чтобы честно измерить качество, нужны предложения, которых модель не видела. Очевидное решение — «отрежем последние 20 % строк» — здесь неверно по двум причинам:
- соседние строки корпуса — соседние предложения одной книги, то есть одна тема и один стиль: тест окажется не про язык, а про конкретное произведение;
- одинаковые русские фразы («— Да, — сказал он.», «Что случилось?») встречаются десятки раз. Часть попадёт в обучение, часть в тест — модель их просто помнит, а метрика покажет несуществующее качество.
Поэтому принадлежность пары определяется хэшем русского предложения: берём предложение, считаем от него хэш-функцию, смотрим остаток от деления на 1000. Остаток 0–4 → валидация, 5–9 → тест, остальное → обучение. Хэш от одинакового текста всегда одинаковый, поэтому все копии фразы неизбежно попадают в одну и ту же часть. Утечка исключена по построению, а не проверкой постфактум. Проверка тем не менее сделана: пересечения нет.
4Как текст превращается в числа
Нужен способ нарезать текст на единицы и присвоить каждой номер. Возможны три уровня, и у каждого своя беда:
| Единица | Словарь | Проблема |
|---|---|---|
| слово | > 300 000 | редкие формы не выучиваются, новые → «неизвестно» |
| буква | ≈ 100 | последовательности длинные, модель тратит силы на сборку слов из букв |
| подслово | 12 000 | компромисс — используется здесь |
Подсловная токенизация находит в корпусе часто встречающиеся куски символов и делает их единицами словаря. Частые слова остаются целыми, редкие разбиваются на знакомые части. Алгоритм — SentencePiece в режиме unigram: он подбирает такой набор кусков, при котором корпус описывается наиболее компактно.
# как модель на самом деле видит текст (символ _ = начало слова)
«Мальчик читает книгу у окна.»
  → _Мальчик │ _читает │ _книгу │ _у │ _окна │ .

«Ача чӳрече умӗнче кӗнеке вулать.»
  → _Ача │ _чӳрече │ _умӗнче │ _кӗнеке │ _вула │ ть │ .
                                                     ↑ основа  ↑ окончание
Обратите внимание на последнюю строку: чувашский глагол
вулать («читает») распался на основу _вула и окончание
ть. Это и есть решение проблемы из раздела 2 — модель работает
с морфемами и потому может собрать словоформу, которой ни разу не
видела, как человек, знающий корень и правило.
Два решения, которые стоит отметить
Словарь один на два языка. Русский и чувашский пользуются кириллицей и делят имена, числа, заимствования, знаки препинания. Общий словарь позволяет использовать одну и ту же матрицу представлений для входа, выхода и финального слоя — экономия около 6 млн параметров, больше трети модели.
Неизвестных символов не бывает. Включён режим «побайтового отката»: символ, не вошедший в словарь (иероглиф, эмодзи, редкий знак), представляется последовательностью байтов. Заглушка «неизвестно» не может появиться в принципе.
| Язык | Подслов на слово | Средняя длина предложения |
|---|---|---|
| русский | 1,87 | 21,1 единицы |
| чувашский | 1,72 | 19,2 единицы |
5Почему Transformer
Transformer — это архитектура нейросети, предложенная в 2017 году в работе с говорящим названием «Attention Is All You Need» («внимание — это всё, что нужно»). Сегодня на ней построено почти всё в обработке языка, включая ChatGPT. Слово «трансформер» здесь не про роботов — оно означает «преобразователь» одной последовательности в другую.
Чтобы понять, зачем она понадобилась, посмотрим на то, что было до неё.
Что было раньше и в чём была беда
Предыдущее поколение переводчиков строилось на рекуррентных сетях (RNN, LSTM). Работали они так: читаем русское предложение слово за словом, накапливая «состояние» — вектор фиксированного размера, скажем 512 чисел. Прочитали до конца — передаём этот вектор второй сети, которая по нему порождает перевод.
Проблема видна на схеме: сколько бы слов ни было во входном предложении — пять или пятьдесят — канал между двумя сетями всегда один и тот же вектор. Это информационное бутылочное горлышко: на длинных предложениях смысл в него не влезает, и качество обваливается.
Transformer убирает горлышко: декодер на каждом шаге видит все позиции входа и сам решает, какие из них сейчас важны. Пропускная способность канала растёт вместе с длиной предложения.
Второй довод — скорость на нашем железе
Рекуррентная сеть считает слова строго по очереди: чтобы обработать пятое, нужен результат четвёртого. Это множество мелких операций, на которых процессор простаивает. В Transformer все позиции считаются одновременно, и вся работа сводится к нескольким большим матричным умножениям — операции, на которой процессор выдаёт пиковую производительность. На нашем четырёхъядерном процессоре разница — почти порядок.
Почему это решало судьбу проекта. Обучение шло 68 часов на обычном процессоре, без видеокарты. С рекуррентной сетью тот же объём вычислений занял бы недели.
6Внимание: главный механизм
Да, внимание применяется — это несущая конструкция всей модели, а не дополнение. Разберём, что именно происходит.
Идея: мягкий поиск по таблице
Представьте обычный поиск в словаре: есть ключи, вы приходите с запросом, находите точное совпадение и забираете значение. Внимание — то же самое, но мягкое: совпадение не «да/нет», а степень похожести, и результат — смесь всех значений в пропорции их похожести на запрос.
Три роли, у каждой позиции своя:
- Запрос (Q, query) — «что мне нужно прямо сейчас»;
- Ключ (K, key) — «что я такое, по какому признаку меня искать»;
- Значение (V, value) — «что я отдам, если меня выберут».
Все три получаются из одного и того же вектора позиции умножением на три разные обучаемые матрицы. То есть сеть сама учится, «как формулировать запрос» и «как себя представлять».
Формула и что в ней происходит
Читается справа налево по смыслу:
- Q · K⊤ — скалярное произведение запроса с каждым ключом. Скалярное произведение тем больше, чем сильнее два вектора «смотрят в одну сторону», то есть это мера похожести. Получаем по числу на каждую позицию входа.
- деление на √dk — техническая, но важная деталь. При размерности 64 суммируются 64 слагаемых, и числа выходят большими; после softmax это дало бы почти нули и почти единицы, а на таких значениях обучение останавливается (градиент исчезает). Деление на корень из размерности возвращает значения в рабочий диапазон.
- softmax — превращает произвольные числа в веса, которые положительны и в сумме дают 1: softmax(z)i = ezi ⁄ Σj ezj. Это и есть «сколько внимания» каждой позиции.
- умножение на V — берём значения с этими весами и складываем. Получился один вектор — выжимка из входа, собранная под текущий запрос.
Как это выглядит в нашей модели на самом деле
Ниже — не иллюстрация из учебника, а настоящие веса внимания, извлечённые из обученной модели на конкретном предложении. По горизонтали — русский вход, по вертикали — порождаемый чувашский выход, яркость клетки — вес. Красной рамкой отмечен максимум в каждой строке.
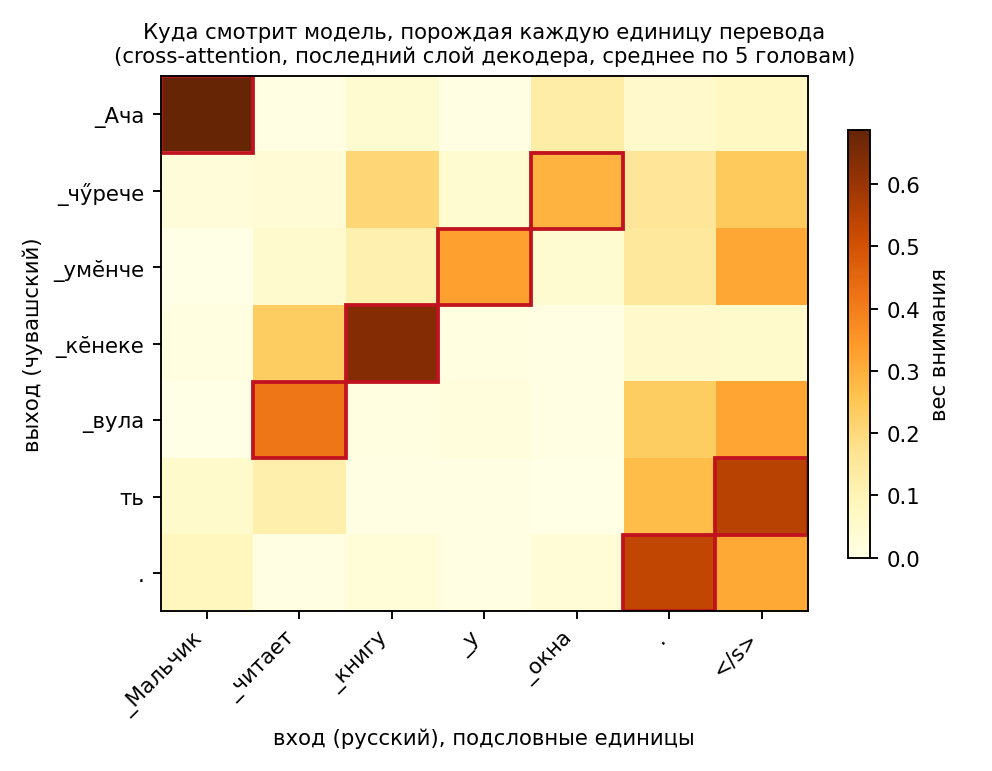
Здесь видно ровно то, что должно происходить при переводе:
| Порождая… | модель смотрит на… | вес |
|---|---|---|
| _Ача (мальчик) | _Мальчик | 0,65 |
| _чӳрече (окно) | _окна | 0,35 |
| _умӗнче (перед, у) | _у | 0,33 |
| _кӗнеке (книга) | _книгу | 0,60 |
| _вула (читать) | _читает | 0,42 |
Модель сама выучила соответствия между словами — их никто не задавал, в обучающих данных были только пары целых предложений.
Самое интересное на этой карте — не диагональ, а её нарушение. В русском порядок «мальчик читает книгу у окна», в чувашском — «ача чӳрече умӗнче кӗнеке вулать»: глагол уходит в конец. И видно, как на пятом шаге внимание прыгает назад к «читает», хотя перед этим уже доходило до «окна». Модель не переводит слово за словом слева направо — она переставляет порядок по правилам целевого языка. Формально: максимум внимания сдвигается вперёд лишь в 33 % шагов.
Три вида внимания в модели
| Где | Кто на кого смотрит | Зачем |
|---|---|---|
| самовнимание в энкодере | русские слова друг на друга | понять связи внутри входа: к чему относится «его», какое слово главное |
| маскированное самовнимание в декодере | уже порождённые чувашские слова друг на друга | согласовать выход с самим собой. «Маскированное» = запрещено смотреть вперёд, иначе на обучении модель подглядывала бы ответ |
| внимание к энкодеру (cross) | чувашский выход на русский вход | собственно перевод — это карта выше |
Почему голов несколько
В нашей модели 5 голов внимания. Одно внимание даёт один взгляд: усреднило по одному признаку похожести — и всё. Вместо этого вектор размерности 320 режется на 5 частей по 64, и внимание считается в каждой независимо. Разные головы специализируются на разном: одна следит за согласованием, другая за связью «предлог—существительное», третья за позицией. Результаты склеиваются обратно. Стоимость та же — работы столько же, просто она разделена.
Чего внимание не знает
Формула внимания не содержит понятия порядка: перемешайте слова входа — веса просто перемешаются, результат для каждого слова не изменится. Для языка это недопустимо: «мать любит дочь» и «дочь любит мать» — разные предложения. Поэтому к вектору каждой позиции перед первым слоем прибавляется позиционное кодирование — набор синусов и косинусов разных частот, уникальный для каждой позиции. По сути к слову подшивается бирка «я стою третьим». Функции фиксированные, не обучаемые: такие работают и на длинах, которых не было в обучении.
7Как модель учится
«Обучение» — это подбор 16,17 млн чисел-параметров. Схема одного шага:
Шаг 1–2: прогон и ошибка
Модель на каждой позиции выдаёт не готовое слово, а распределение вероятностей по всем 12 000 единицам словаря: «здесь кӗнеке с вероятностью 0,7, кӗнекене с 0,2, остальное по мелочи». Ошибка считается функцией перекрёстной энтропии:
Логарифм здесь — не украшение. Он делает штраф несимметричным: если модель дала правильному ответу вероятность 0,5 — штраф 0,69; если 0,01 — штраф уже 4,6. То есть уверенная ошибка наказывается несопоставимо сильнее, чем неуверенная. Именно это заставляет модель не гадать, а разбираться.
Перплексия
Число из графиков обучения. Это просто eL, но с наглядным смыслом: среди скольких равновероятных вариантов модель фактически выбирает. У нашей модели 8,5 — при словаре 12 000 единиц она сузила выбор примерно в 1400 раз. В начале обучения было 709, то есть почти наугад. Меньше — лучше, идеал — 1.
Шаг 3: градиент и обратное распространение
Градиент — это ответ на вопрос «если я чуть увеличу вот этот конкретный параметр, ошибка вырастет или упадёт, и насколько сильно?». Формально — частная производная ошибки по параметру.
Считать его отдельно для каждого из 16 миллионов параметров было бы безумно дорого. Обратное распространение ошибки (backpropagation) считает все градиенты сразу, за один проход от выхода к входу, применяя правило дифференцирования сложной функции. Стоимость — примерно два прогона вперёд. Это тот алгоритм, без которого глубокое обучение было бы невозможно.
Аналогия. Вы в тумане на склоне и хотите спуститься. Видимости нет, но под ногами чувствуете уклон — в какую сторону вниз и насколько круто. Это градиент. Делаете шаг в эту сторону, снова щупаете, снова шагаете. Ошибка — высота, параметры — координаты, только координат 16 миллионов.
Шаг 4 — это раздел 8. А пока — три приёма
Сглаживание меток (label smoothing 0,1)
Мы говорим модели: правильный ответ должен получить не 100 % вероятности, а 90 %, остальное распредели по прочим. Зачем нарочно портить цель? Потому что у перевода нет единственно верного ответа — синонимы законны. Требование абсолютной уверенности учит зубрить корпус. Кроме того, приём улучшает калибровку вероятностей, а на них опирается поиск при переводе (раздел 9).
Dropout 0,15
На каждом шаге обучения случайные 15 % связей отключаются. Модель не может положиться на конкретный «нейрон-знаток» и вынуждена дублировать знание разными путями. Аналог: студент, у которого на каждом занятии отсутствует случайная часть конспекта, поневоле разбирается в предмете. При работе модели dropout выключается.
Батчи и почему они собраны по длине
Параметры правятся не по одному примеру, а по среднему градиенту от
батча — иначе шаги были бы слишком шумными. Но предложения
разной длины, а матрицы должны быть прямоугольными, поэтому короткие
дополняют пустышкой <pad>.
И вот тут наивный подход разоряет: при медиане 17 единиц и максимуме 173, если дополнять всё до максимума, около 85 % всех вычислений уйдёт на пустышку. Решение — складывать в один батч предложения похожей длины и набирать батч не по числу предложений, а по бюджету токенов. Замер: 99,9 % вычислений полезны. Это ускорение не изменило модель ни на грамм — просто перестало тратить процессор впустую.
Эпоха
Один полный проход по всем 984 627 парам. Наша модель прошла 9,7 эпохи за 68 часов: примерно 6,6 часа на эпоху при скорости ≈780 единиц текста в секунду.
8Adam — как делается шаг
Градиент говорит, в какую сторону идти. Он не говорит, насколько крупный делать шаг. Этим занимается оптимизатор.
Название Adam — сокращение от adaptive moment estimation, «оценка моментов с адаптацией». «Моменты» — усреднённые характеристики градиента; «адаптация» — своя длина шага для каждого параметра. Предложен в Kingma & Ba, 2014 и с тех пор остаётся рабочей лошадкой всего глубокого обучения.
Почему простого спуска мало
Самый прямой способ — шагнуть против градиента: θ ← θ − η · g, где η — длина шага. Две беды:
- Одна длина шага на всех. У разных параметров склоны различаются в тысячи раз. Шаг, подходящий крутому, для пологого — стояние на месте; шаг для пологого крутого раскачивает.
- «Овраги». Типичная поверхность ошибки — длинная узкая ложбина. Градиент указывает почти поперёк неё, поэтому спуск скачет от стенки к стенке и почти не движется вдоль.
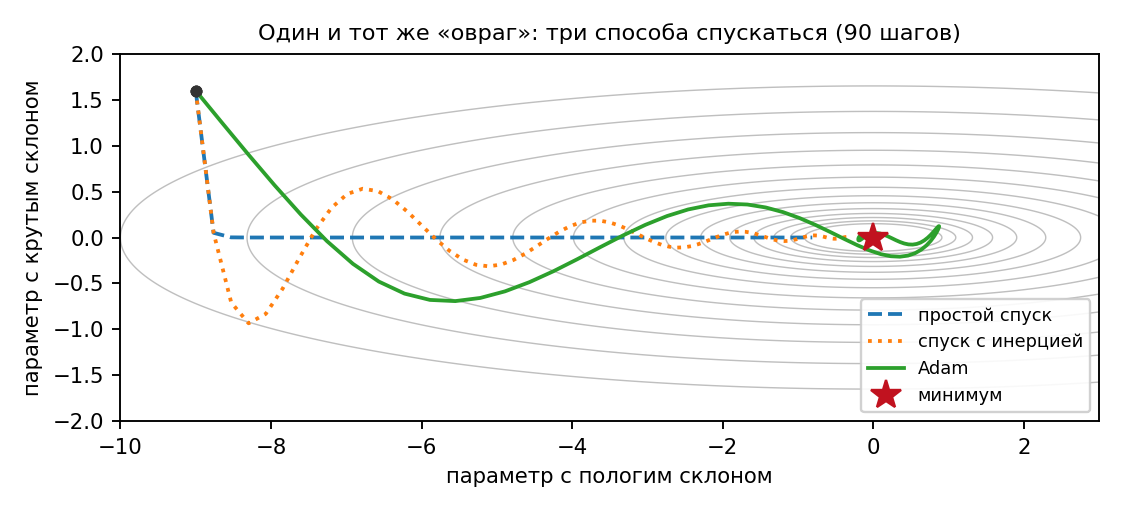
Замер на этой картинке: расстояние до минимума после 90 шагов — 0,81 у простого спуска, 0,30 с инерцией, 0,010 у Adam.
Механика: две накопленные величины
Adam хранит для каждого параметра два бегущих средних градиента.
Первый момент — инерция (направление)
Это физическая инерция: шар, катящийся с горы, не мечется от каждой кочки — он помнит направление. Случайные колебания взаимно гасятся, общий уклон остаётся. При β1 = 0,9 память — примерно последние 10 шагов.
Второй момент — масштаб (длина шага)
Квадрат убирает знак, поэтому v — оценка типичной величины градиента у данного параметра, независимо от направления.
Собственно шаг
Вот ключевой момент, ради которого всё и делалось: деление на √v. Если у параметра градиенты стабильно большие, знаменатель велик — шаг укорачивается. Если градиенты мелкие, знаменатель мал — шаг удлиняется. В итоге каждый из 16 миллионов параметров получает свою длину шага, и «пологие» направления перестают быть медленными. Именно поэтому на картинке выше Adam идёт вдоль оврага, а не поперёк.
ε = 10−9 — защита от деления на ноль. Шляпки в m̂, v̂ — поправка на «холодный старт»: оба средних начинаются с нуля и первое время занижены, поэтому их делят на 1 − βt.
W в AdamW (наш вариант) — про регуляризацию весов: к ошибке добавляется штраф за большие значения параметров, что удерживает модель от переусложнения. Буква W означает, что штраф применяется отдельно от адаптивного масштабирования — так корректнее, чем в исходном Adam.
Расписание скорости обучения
η в формуле — не константа. Она меняется по расписанию:
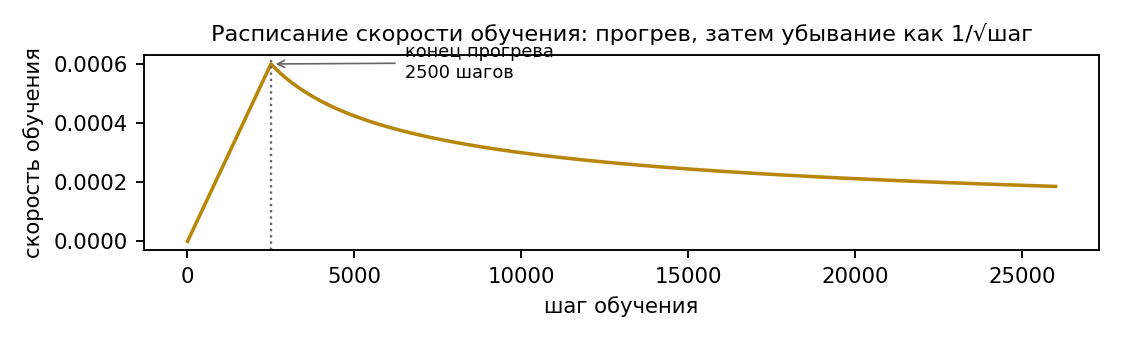
Зачем прогрев (первые 2500 шагов). Не «чтобы плавно начать» — причина конкретнее. При β2 = 0,98 оценка v на первых шагах почти нулевая, значит знаменатель почти нулевой, значит шаг огромен. Такие шаги в первые же минуты разносят модель так, что она уже не восстанавливается. Прогрев держит η малым, пока v не наберёт статистику.
Зачем убывание потом. Крупные шаги хороши, пока мы далеко от цели. У минимума они начинают перепрыгивать через него. К концу нашего обучения η упала примерно до 1,9·10−4 — втрое от пика.
Побочный вывод из нашего прогона. Приём «усреднить веса последних пяти контрольных точек» обычно даёт заметный бесплатный прирост, а у нас дал всего 0,35 пункта. Причина видна на графике: к моменту остановки скорость обучения ещё не упала до малых значений, то есть контрольные точки лежат на склоне спуска, а не вокруг дна. Усреднять точки на склоне бессмысленно.
9Как делается перевод
Обучение закончено, параметры зафиксированы. Что происходит, когда вы нажимаете «Перевести».
Авторегрессия — и откуда это слово
Термин пришёл из статистики временных рядов, где авторегрессионная модель AR(p) предсказывает следующее значение ряда по его же прошлым значениям:
«Авто-» здесь значит «сам»: ряд регрессируется на себя самого. В обработке языка термин используется в обобщённом смысле, и в этом обобщённом смысле он к нашей модели применим буквально: единица на шаге t предсказывается по единицам, которые модель породила на шагах до t. Само это свойство и есть авторегрессивность.
Но общее у них только это свойство. Разница существенная:
| Классическая AR(p) | Наш декодер | |
|---|---|---|
| Что предсказывает | одно число | распределение по 12 000 дискретных единиц |
| Вид зависимости | линейная, p коэффициентов φ | нелинейная, 16,17 млн параметров |
| Глубина памяти | фиксированные p шагов назад | вся порождённая последовательность |
| Внешний вход | нет | есть — русское предложение |
| Случайность | аддитивный шум εt | сама модель выдаёт распределение |
Из-за внешнего входа строже было бы говорить об условной авторегрессии — ближайший аналог в статистике это ARX, авторегрессия с внешним воздействием. Коэффициенты φ заменены на всю нейросеть, а вместо точечного прогноза выдаётся распределение.
Термин здесь не декоративный. Существуют и неавторегрессивные модели перевода: они порождают все единицы выхода одновременно, независимо друг от друга, за один проход — быстрее, но заметно хуже по качеству, потому что слова перевода не согласуются между собой. Это отдельное направление исследований, названное именно через отрицание нашего свойства (Kasai et al., 2021). То есть авторегрессивность — содержательная характеристика конструкции, а не фигура речи.
Формально модель раскладывает вероятность всего перевода в произведение условных вероятностей — это и есть запись авторегрессии для дискретной последовательности:
Порядок работы: энкодер один раз обрабатывает русский вход. Затем декодер получает служебный символ «начало» и выдаёт распределение по словарю. Выбираем единицу, приписываем её к выходу, подаём обратно на вход декодера, получаем следующее распределение — и так до символа «конец».
Важная тонкость: при обучении модель работает НЕ авторегрессивно. Если бы на обучении мы подавали ей её собственные предсказания, то из-за ранних ошибок она обучалась бы на бессмысленных префиксах, и все 26 000 шагов пришлось бы делать строго последовательно. Поэтому на обучении на вход декодера подаётся правильный ответ, сдвинутый на одну позицию (приём называется teacher forcing, «обучение с подсказкой»), а от подглядывания вперёд спасает маска: позиция t физически не видит позиции после себя. Благодаря этому все позиции считаются за один проход параллельно — именно то, что делает Transformer быстрым на обучении.
В коде это видно прямо: при обучении вызывается
model(src, tgt_in) с причинной маской сразу на всю длину, а при
переводе — decode(tokens[:, -1:], …) в цикле по одному шагу.
Авторегрессия — свойство разложения вероятности и режима перевода, а не
способа обучения.
У этого расхождения есть известное следствие: при обучении модель всегда видела правильный префикс, а при переводе опирается на свой собственный, возможно ошибочный. Из-за этого одна ошибка способна утянуть за собой остальную часть предложения. Явление называют exposure bias, и поиск по лучу (ниже) частично его сглаживает, перебирая несколько вариантов префикса вместо одного.
Как выбирать: жадно, случайно или лучом
На каждом шаге у нас распределение по 12 000 вариантов. Как выбрать?
Жадно — брать самый вероятный. Быстро, но недальновидно: локально хорошее начало может завести туда, откуда достойного продолжения нет, а откатиться нельзя.
Случайно (сэмплирование с температурой) — тянуть из распределения. Уместно в генерации текста, где ценится разнообразие. Для перевода — методическая ошибка: у входного предложения есть правильный ответ, и внесение случайности может результат только испортить.
Поиск по лучу (beam search) — то, что используется здесь. Держим k лучших частичных переводов одновременно, каждый продолжаем всеми вариантами, из всех получившихся оставляем снова k лучших. В конце берём лучшую последовательность целиком.
Складываются логарифмы вероятностей, а не умножаются сами вероятности: перемножение сотни чисел меньше единицы даёт значение, которое не помещается в машинную точность. Логарифм переводит произведение в сумму — приём стандартный.
Поправка на длину
Тут прячется ловушка. Оценка — сумма логарифмов, каждый отрицательный, поэтому чем длиннее перевод, тем хуже его оценка просто в силу длины. Без поправки поиск систематически выбирал бы короткие варианты, обрывая предложение. Поэтому оценку нормируют:
Насколько широкий луч нужен — замер
| Ширина луча | chrF2 | BLEU | мс на предложение |
|---|---|---|---|
| 1 (жадно) | 44,49 | 16,48 | 39 |
| 2 | 44,79 | 16,46 | 51 |
| 4 | 44,94 | 16,76 | 81 |
| 8 (используется) | 45,13 | 17,05 | 129 |
Проверять это было обязательно: у поиска по лучу известен эффект, когда слишком широкий луч начинает ухудшать перевод. У нашей модели качество растёт монотонно до 8, поэтому в сервисе стоит 8.
Кэш ключей и значений
Наивно на каждом шаге декодер пересчитывал бы самовнимание по всему уже порождённому тексту заново — сложность растёт как квадрат длины. Но ключи и значения прошлых позиций не меняются, их достаточно сохранить. На предложениях в 20+ единиц это ускоряет перевод в 3–5 раз.
Как проверялась правильность. Кэш — место, где легко незаметно ошибиться. Проверено двумя тождествами: жадный перевод с кэшем должен посимвольно совпадать с расчётом без кэша, а поиск по лучу ширины 1 должен быть тождественно равен жадному. Оба выполняются.
10Как измерить качество
«На глаз» не работает: нужно сравнивать версии и замечать ухудшения. Метрика сопоставляет перевод модели с человеческим эталоном на предложениях, которых модель не видела.
BLEU — совпадение цепочек слов
Самая известная метрика. Считает, какая доля цепочек из 1, 2, 3 и 4 слов подряд в переводе модели встречается в эталоне, и перемножает эти доли (плюс штраф за слишком короткий вывод). Наше значение — 18,71.
chrF2 — совпадение цепочек символов, и почему она здесь главная
То же самое, но на уровне символов. Для нашей задачи это принципиально, и причина — ровно в агглютинативности из раздела 2.
Пусть эталон — кӗнекесем («книги»), а модель выдала кӗнекене. Корень угадан, ошибка в аффиксе — перевод почти верен. Но для BLEU это совершенно другое слово: совпадение нулевое, а вместе с ним обнуляются все четырёхграммы, куда это слово входило. Одна промашка в аффиксе стирает вклад четырёх слов. chrF2 видит, что совпало 7 символов из 10, и ставит справедливую оценку.
Поэтому основная метрика проекта — chrF2 = 46,15. Дополнительно считается TER — доля правок до эталона, то есть «сколько работы останется редактору», у нас 70,35 (меньше — лучше).
Чего с этими числами делать нельзя
Сравнивать абсолютные значения между языками и тестами. Рассуждение «у нас BLEU 18, а у систем англ.→нем. 40, значит наша плохая» — некорректно. Метрика зависит от того, насколько буквальны эталоны, от предметной области, длины предложений и числа эталонных переводов. Корректно сравнивать две системы на одном тесте с одними эталонами — и ничего больше.
Как это выглядит в жизни: при сравнении с промышленным переводчиком на
одинаковом тесте выяснилось, что он оформляет реплики дефисом -,
а эталоны корпуса и наша модель — тире —. Это затронуло 70 из 300
предложений и занижало его BLEU на 1,78 пункта — достаточно, чтобы вывод
сравнения перевернулся на противоположный. Один типографский символ. После
нормализации пунктуации разрыв составил 2,67 пункта chrF2 в пользу
промышленной системы.
11Словарь терминов
- Агглютинативный язык
- Язык, где значения приклеиваются к основе цепочкой отдельных аффиксов, каждый со своим смыслом. Чувашский, татарский, турецкий, финский. Противоположность — флективный (русский), где окончание сплавлено с основой и выражает сразу несколько значений.
- Токен, подсловная единица
- Минимальный кусок текста, с которым работает модель. Не обязательно слово: частые слова целиком, редкие — по частям. В нашем словаре 12 000.
- Эмбеддинг
- Вектор чисел (у нас 320), представляющий токен. Обучается так, чтобы близкие по смыслу токены оказались близкими векторами.
- Энкодер / декодер
- Энкодер читает исходное предложение и строит его представление. Декодер по этому представлению порождает перевод. У нас 6 слоёв энкодера и 3 декодера — асимметрия намеренная: декодер работает на каждую порождаемую единицу, и его сокращение вдвое напрямую ускоряет перевод.
- Внимание (attention)
- Механизм, позволяющий на каждом шаге взвешенно смотреть на все позиции сразу. Мягкий поиск по таблице: запрос сравнивается со всеми ключами, результат — смесь значений в пропорции похожести.
- Softmax
- Функция, превращающая произвольные числа в вероятности: возводит в экспоненту и делит на сумму. Результат положителен и в сумме даёт 1.
- Градиент
- Вектор частных производных ошибки по параметрам. Отвечает на вопрос «куда и насколько сдвинуть каждый параметр, чтобы ошибка упала».
- Обратное распространение (backpropagation)
- Алгоритм, вычисляющий все градиенты за один проход от выхода к входу по правилу дифференцирования сложной функции.
- Оптимизатор, Adam
- Правило превращения градиента в конкретную поправку. Adam хранит два бегущих средних (градиента и его квадрата) и потому даёт каждому параметру свою длину шага.
- Перплексия
- e в степени ошибки. Показывает, среди скольких равновероятных вариантов модель фактически выбирает. У нас 8,5 при словаре 12 000.
- Эпоха
- Один полный проход по обучающей выборке. У нас 9,7 эпохи за 68 часов.
- Батч
- Порция примеров, обрабатываемая за один шаг. Параметры правятся по среднему градиенту батча, что снижает шум.
- Dropout
- Случайное отключение части связей при обучении. Мешает модели полагаться на отдельные элементы и тем снижает переобучение.
- Переобучение
- Состояние, когда модель запомнила обучающие примеры вместо усвоения закономерностей: ошибка на обучении падает, на проверочных данных растёт. У нас не наблюдалось — валидационная ошибка убывала до конца.
- Авторегрессия
- Порождение по одной единице, где каждая следующая зависит от всех уже порождённых.
- Поиск по лучу (beam search)
- Стратегия декодирования: одновременно ведётся k лучших частичных гипотез, в конце выбирается лучшая целиком.
- BLEU / chrF2 / TER
- Метрики качества: совпадение по цепочкам слов / по цепочкам символов / доля правок до эталона. Для морфологически богатых языков надёжнее chrF2.
12Что почитать дальше
Если хочется понять на пальцах
- 3Blue1Brown, «Neural networks» — видеокурс. Лучшее визуальное объяснение градиентного спуска и обратного распространения. Есть выпуски отдельно про Transformer и внимание. Русские субтитры есть.
- Jay Alammar, «The Illustrated Transformer» — разбор архитектуры по картинкам, шаг за шагом. Классика жанра; если читать что-то одно про Transformer, то это.
- Он же, «Visualizing Neural Machine Translation» — про бутылочное горлышко и как внимание его снимает. Ровно тема раздела 5.
- Distill, «Attention and Augmented Recurrent Neural Networks» — интерактивные анимации внимания.
Если хочется разобраться в деталях
- «The Annotated Transformer», Harvard NLP
— статья 2017 года, переписанная как исполняемый код с
пояснением каждой строки. Ближе всего к тому, что делает наш
src/model.py. - Andrej Karpathy, «Let's build GPT from scratch» — два часа, за которые Transformer собирается с нуля на пустом файле. Лучший способ убедиться, что внутри нет магии.
- Goodfellow, Bengio, Courville, «Deep Learning» — учебник, доступен бесплатно. Главы 6–8 про обучение и оптимизацию. Есть русский перевод («Глубокое обучение»).
- «Dive into Deep Learning» — учебник с исполняемым кодом, есть русская версия. Разделы про внимание и машинный перевод особенно уместны.
Первоисточники (то, на что опирается наша модель)
- Vaswani et al., «Attention Is All You Need», 2017 — сама архитектура Transformer.
- Bahdanau, Cho, Bengio, 2015 — работа, впервые применившая внимание к переводу.
- Kingma & Ba, «Adam», 2014 — оптимизатор из раздела 8.
- Loshchilov & Hutter, «AdamW», 2019 — исправление регуляризации весов, наш вариант.
- Kudo & Richardson, «SentencePiece», 2018 — подсловная токенизация из раздела 4.
- Popović, «chrF», 2015 — метрика, которая у нас основная.
- Post, «A Call for Clarity in Reporting BLEU», 2018 — почему нельзя сравнивать BLEU между работами. Прямо про раздел 10.
- Kasai et al., «Deep Encoder, Shallow Decoder», 2021 — почему у нас 6 слоёв энкодера и 3 декодера.